主题
第十二章:缓存击穿、穿透、雪崩
形而上学的区分击穿与穿透:击穿透对应着redis和数据库的前后关系,击穿的 redis,穿透数据库。
缓存击穿
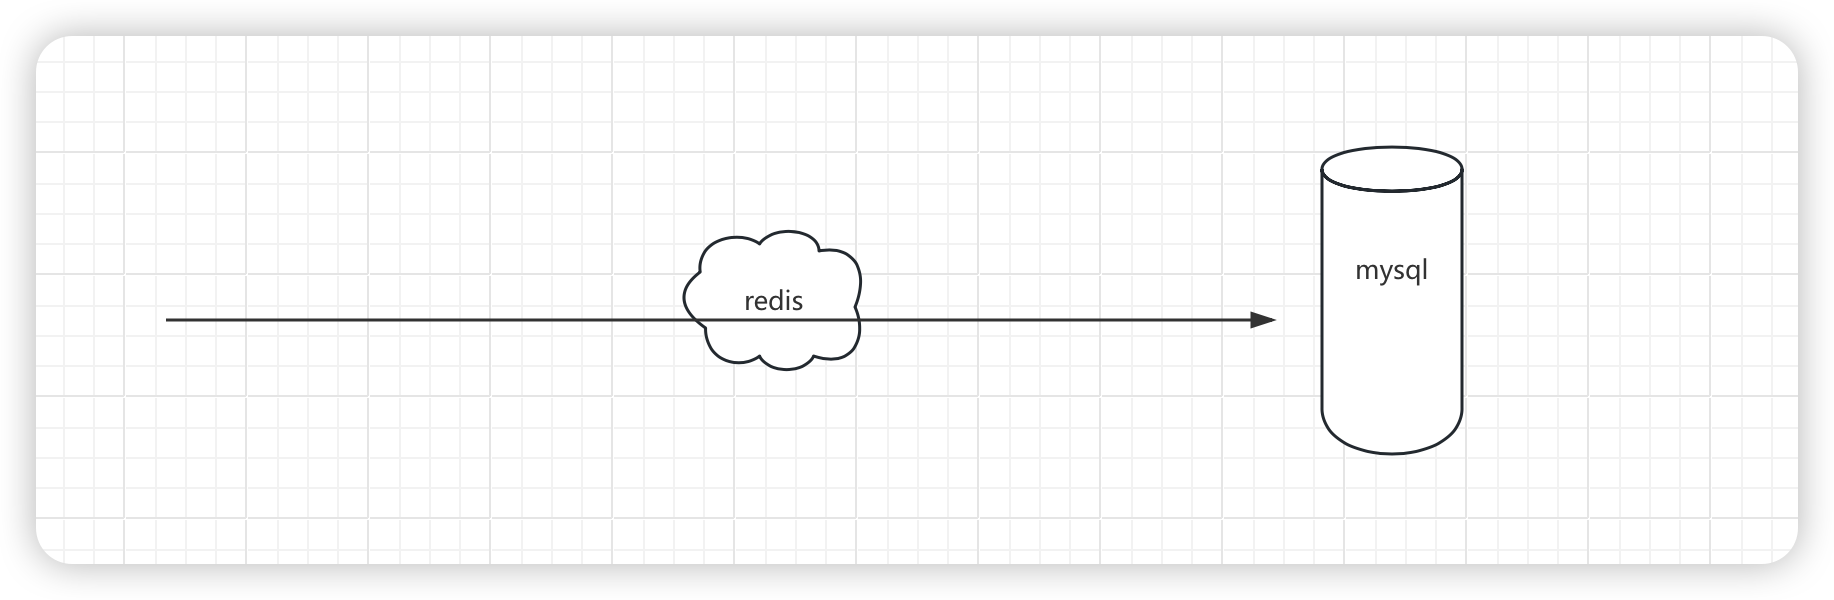
缓存穿透
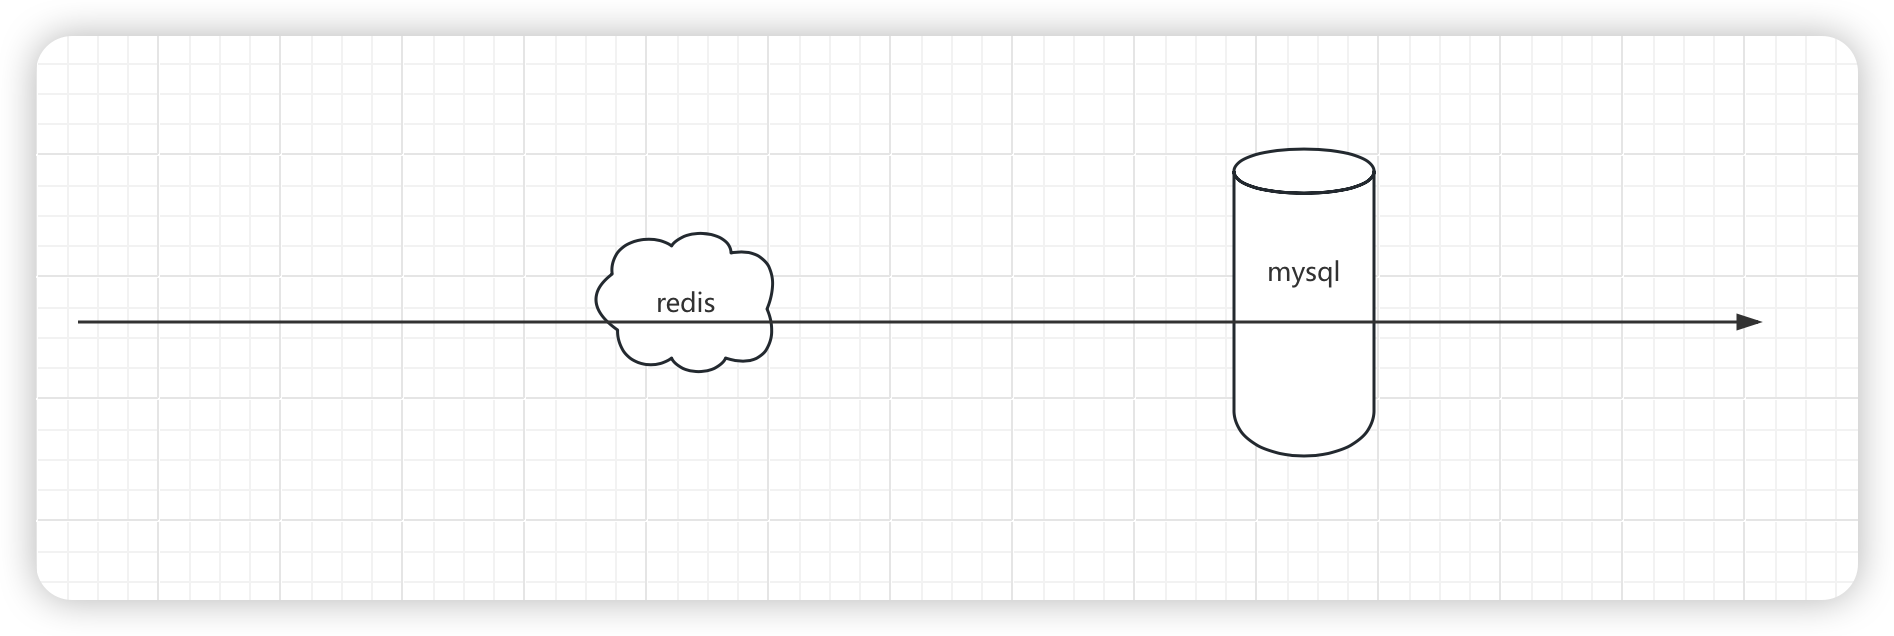
缓存雪崩
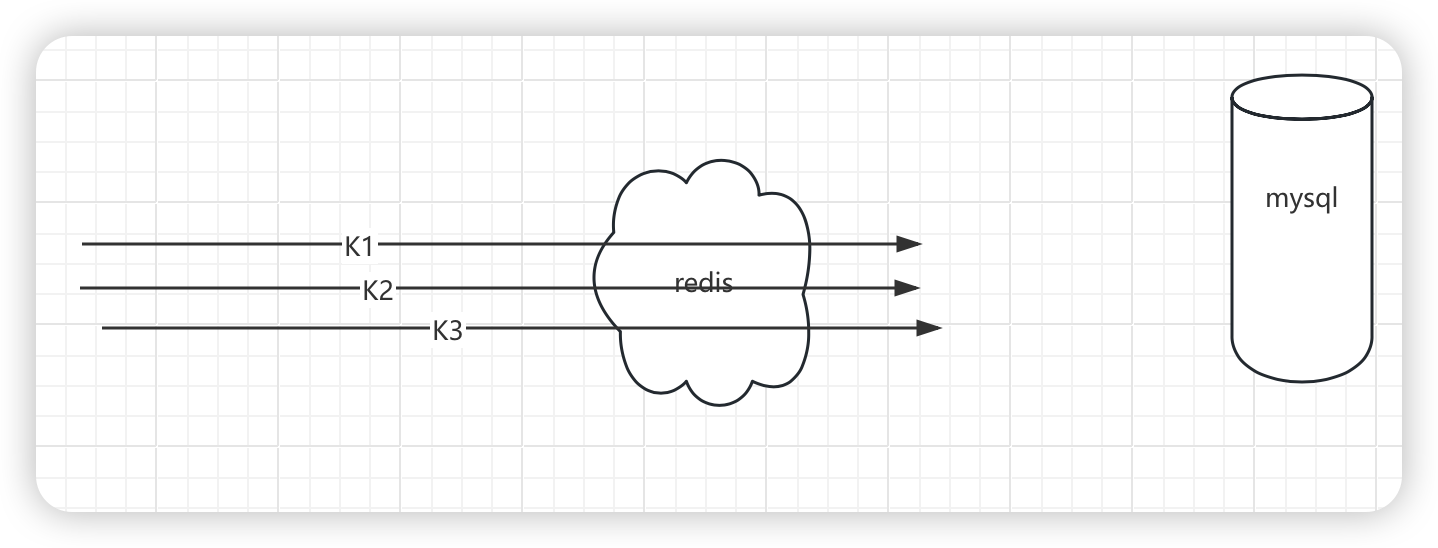
Q37:缓存击穿、缓存穿透、缓存雪崩分别是什么?它们之间有什么区别?
答:
这是三个最容易混为一谈的概念。它们的共同点是「缓存没挡住请求,压力传导到了数据库」,但触发原因和应对手段完全不同。先用一句话区分:
- 缓存击穿:某个热点数据在缓存过期的一瞬间,大量并发请求同时回源数据库。
- 缓存穿透:查一个根本不存在的数据,缓存和数据库里都没有,请求每次都「穿透」缓存直达数据库。
- 缓存雪崩:大量缓存同时过期,或缓存服务(Redis)整体不可用,导致海量请求集中打到数据库。
三个概念的关系可以这样看:
text
            ┌────────────────────────────── 缓存层 ──────────────────────────────┐
请求 ──────► │  命中缓存?                                                          │
            │     │                                                              │
            │     ├─ 命中 ──► 直接返回                                            │
            │     │                                                              │
            │     └─ 未命中 ──► 回源数据库                                         │
            └────────────────────────────────────────────────────────────────────┘
                                              │
                    ┌─────────────────────────┼─────────────────────────┐
                    │                         │                         │
              缓存穿透                     缓存击穿                     缓存雪崩
          查「不存在」的数据              热点 key 刚好过期           大量 key 同时过期
每次都打到数据库 并发同时回源 请求集中打到数据库下面用一张 Mermaid 图把三条链路画出来:
mermaid
flowchart TD
    A[客户端请求] --> B{缓存中是否命中}
    B -- 命中 --> C[直接返回缓存数据]

    B -- 未命中 --> D{这个 key 在数据库里是否存在}

    D -- 不存在 --> E[缓存穿透<br/>恶意/无效 key 反复穿透到 DB]
    D -- 存在但已过期 --> F{是否是热点 key}

    F -- 是热点、瞬间大量并发 --> G[缓存击穿<br/>热点 key 过期瞬间并发回源]
F -- 大量 key 同一时间过期 --> H[缓存雪崩<br/>海量请求集中打到 DB]三个概念的核心差异对比:
| 维度 | 缓存穿透 | 缓存击穿 | 缓存雪崩 |
|---|---|---|---|
| 触发对象 | 不存在的数据 | 单个热点 key | 大量 key 或整个缓存层 |
| 根本原因 | 数据本来就不存在,缓存永远无法命中 | 热点 key 过期瞬间,锁不住并发 | 过期时间集中 / Redis 整体宕机 |
| 命中情况 | 缓存、数据库都查不到 | 缓存刚好过期,数据库里有真实数据 | 缓存大面积失效,数据库里有真实数据 |
| 典型后果 | 数据库被无效请求反复冲击,甚至被打垮 | 数据库瞬间承受热点数据的全部并发 | 数据库整体压力陡增,可能雪崩式宕机 |
| 关键解决手段 | 缓存空值、布隆过滤器、参数校验 | 互斥锁、逻辑过期、热点预热 | 过期时间随机化、高可用、多级缓存、限流降级 |
| 一句话记忆 | 「查的是没有的东西」 | 「一个热点刚过期就被群殴」 | 「大家一起过期,一起爆炸」 |
三种问题分别有什么危害?
它们的共同危害是:原本应由缓存承担的请求落到数据库,消耗数据库和应用资源,导致响应变慢、请求超时;超过系统承载能力时,还可能造成服务不可用。 具体区别在于压力的来源和影响范围。
1. 缓存击穿:单个热点失效,造成瞬时并发冲击
- 热点 key 失效后,大量请求同时查询同一份数据,数据库出现重复查询,CPU、I/O 和连接数短时间内飙升。
- 回源变慢会延长缓存重建的空窗期,更多请求继续回源,进一步加重数据库压力。
- 热点接口出现延迟、超时或失败;如果耗尽共享数据库连接池或应用线程池,还会拖慢其他正常接口。
例如:秒杀商品详情缓存过期,大量用户同时刷新页面,数据库被同一商品的查询集中冲击,可能连带影响下单等共用数据库的业务。
2. 缓存穿透:无效请求持续回源,浪费资源并挤占正常业务容量
- 不存在的数据每次都要到数据库查询,即使结果为空,也会消耗连接、查询执行和网络传输等资源。
- 在没有缓存空值或前置过滤时,这类请求无法通过缓存命中减轻压力;恶意请求不断更换不存在的 key,可能形成持续的数据库攻击流量。
- 大量无效查询挤占正常请求的资源,导致正常用户访问变慢、超时,严重时数据库或应用服务不可用。
例如:攻击者不断请求不存在的商品 ID,虽然查不到任何商品,数据库仍要处理这些查询,真实商品的查询也会受到影响。
3. 缓存雪崩:大面积失效,可能引发系统级连锁故障
- 大量 key 同时过期或 Redis 整体不可用,使多个接口同时回源,数据库整体负载陡增,影响范围通常比单个热点击穿更广。
- 数据库响应变慢后,请求在应用中堆积,占用连接池、线程池和内存;超时后的重试若缺少限制,会进一步放大流量。
- 数据库过载可能沿着调用链扩散到多个服务,形成连锁故障,严重时导致大范围业务不可用。
- 即使 Redis 恢复,若缓存尚未重建,回源压力仍可能持续,导致业务恢复缓慢。
例如:首页、商品、库存等大量缓存同时失效,多个业务一起访问数据库,数据库过载又拖累依赖它的服务,最终形成大面积超时。
记忆重点:击穿是「一个热点带来瞬时洪峰」,穿透是「无效查询持续消耗资源」,雪崩是「大面积回源引发连锁故障」。三者都可能拖垮数据库,实际严重程度取决于流量、系统容量和保护措施。
Q38:缓存穿透如何解决?
答:
穿透的本质是「查不到的数据没有被缓存挡住」。所以思路只有两条:要么让查不到的结果也能被缓存,要么在缓存之前就把明显不存在的请求拦掉。常见手段有四种,可以组合使用。
方案一:缓存空值(最简单)
数据库查不到时,不直接返回,而是往缓存里写一个「空值标记」,并设置一个较短的 TTL。这样后续同样的请求在 TTL 内就能命中缓存,不再打到数据库。
text
第一次请求 goods:99999(不存在)
  └─► 查缓存:无
  └─► 查 DB:无
  └─► 写入缓存 goods:99999 = "__NULL__",TTL = 60s

第二次请求 goods:99999(60 秒内)
  └─► 查缓存:命中 "__NULL__"
└─► 直接返回「不存在」,不再打 DBPython 伪代码:
python
def get_goods(goods_id: str):
    cached = redis_client.get(f"goods:{goods_id}")
    if cached is not None:
        return None if cached == "__NULL__" else cached

    goods = db.query_goods(goods_id)

    if goods is None:
        redis_client.set(f"goods:{goods_id}", "__NULL__", ex=60)
        return None

    redis_client.set(f"goods:{goods_id}", goods, ex=600)
return goods上面这种「查不到也写缓存」的做法,业内也叫回写增强:DB 查不到时,往缓存里写一个和业务约定的缺省值(如 0、-1、defaultNull、__NULL__ 等),把「穿透」的第二次请求挡在缓存层。
注意点:
- 空值 TTL 不要设太长,否则数据库新增了这条数据后,缓存还停留在「空值」状态;
- 缺省值方案只对相同的 key 有效,恶意攻击者若不断换新 key,缺省值就挡不住,所以通常要配合参数校验和限流;
- 海量不同 key 刷空值会占用 Redis 内存,需要关注容量。
方案二:布隆过滤器 / 黑白名单(防海量无效 key)
在缓存之前加一层布隆过滤器(有些资料里也把它叫「黑白名单」),把所有「真实存在的 key」提前写入布隆过滤器。请求进来先问布隆过滤器:
- 布隆过滤器说「不存在」→ 该 key 一定不存在,直接返回,不打 DB;
- 布隆过滤器说「可能存在」→ 正常走缓存 → DB。
text
请求 goods:99999
  └─► BF.EXISTS bf:goods:ids goods:99999  → 0(一定不存在)
  └─► 直接返回「不存在」,全程不打 DB

请求 goods:1001
  └─► BF.EXISTS bf:goods:ids goods:1001  → 1(可能存在)
└─► 查缓存 → 未命中 → 查 DB → 命中布隆过滤器适合「key 空间巨大、且大量请求是无效 key」的场景。它的代价是:有误判率(可能把不存在的误判为存在),且删除元素困难(需要可删除的 Cuckoo Filter)。所以布隆过滤器是「减负」而不是「精确判断」。
构建布隆过滤器时,需要把现有真实 key 一次性灌入,这个过程也叫缓存预热:系统启动时,提前把相关的数据加载到 Redis 缓存系统(或过滤器)中,避免用户请求来时才临时加载、瞬间打爆数据库。
方案三:参数合法性校验(第一道防线)
很多穿透请求的 key 本身就不符合业务规则,例如负数 id、超范围 id、畸形字符串。在进入缓存之前先做基础校验,直接拦掉:
python
def get_goods(goods_id: str):
    if not goods_id.isdigit():
        return None
    if int(goods_id) <= 0 or int(goods_id) > 10_000_000:
        return None
...这一层几乎零成本,能挡掉大量随机伪造的请求。
方案四:限流 / 熔断(最后兜底)
对单接口、单 IP 做限流,当数据库压力过大时触发熔断,快速失败或降级返回。这一层属于通用保护,不只是为穿透设计,但在攻击场景下能保护数据库不死。
组合建议:先做参数校验,再加缓存空值,key 空间特别大时引入布隆过滤器,最后用限流熔断兜底。
Q39:缓存击穿和缓存雪崩如何解决?
答:
击穿和雪崩都发生在「缓存失效」之后,但失效范围不同,所以解决思路也分「单点」和「整体」两条线。
一、缓存击穿的解决(针对单个热点 key)
核心矛盾是:热点 key 过期后,同一时刻大量请求同时回源。解决思路是让「回源」这件事被串行化,或者干脆不让热点 key 真正过期。
热点 key 之所以会「突然失效」,通常来自两类情形:
- 自然过期后被访问:热点 key 无时无刻在接受大量并发访问,TTL 一到、缓存失效瞬间,大量请求同时涌入后端;
- 被主动 delete 后又被访问:运维或业务主动删除了某个 key,而这个 key 恰好是热点,紧接着的高并发访问就会击穿缓存直达数据库。
针对第一类情形,访问频繁的热点 key 甚至可以直接不设过期时间;针对第二类,需要靠互斥锁、二级缓存等手段在失效后挡住并发。
方案 1:互斥锁 / 分布式锁
回源之前先抢锁,抢到锁的请求去查 DB 并回填缓存,没抢到的等待或重试:
text
并发请求 A、B、C 同时查热点 key,缓存已过期
  ├─► A 抢到锁(SET lock:goods:1001 NX EX 10)
  │      └─► 查 DB → 回填缓存 → 释放锁
  ├─► B 没抢到锁 → 休眠重试 → 此时缓存已有数据 → 命中返回
└─► C 没抢到锁 → 休眠重试 → 命中返回Python 伪代码(用 SET NX EX 实现锁):
python
import time

def get_hot_goods(goods_id: str):
    cache_key = f"goods:{goods_id}"
    lock_key = f"lock:goods:{goods_id}"

    cached = redis_client.get(cache_key)
    if cached is not None:
        return cached

    # 尝试抢锁,抢不到就重试
    if redis_client.set(lock_key, "1", nx=True, ex=10):
        try:
            goods = db.query_goods(goods_id)
            redis_client.set(cache_key, goods, ex=600)
            return goods
        finally:
            redis_client.delete(lock_key)

    time.sleep(0.05)
return get_hot_goods(goods_id)锁方案的优点是实现直接、一致性强;缺点是引入锁后复杂度上升,需要设置锁超时避免死锁,抢不到锁的请求会有短暂等待。
这里锁的方案又可以细分成「本地锁」和「分布式锁」两种选型:
- 本地锁(如
synchronized、Lock):适用于单体应用,进程内串行化即可,实现最简单; - 分布式锁(如 Redisson、基于
SET NX EX或 Lua 实现):适用于分布式应用,多个实例部署时必须用分布式锁才能跨进程互斥。
在抢锁前后各查一次缓存,就是经典的**双检加锁(Double-check Locking)**模式。用「第一检 → 加锁 → 第二检」三步,把「查 DB」严格限制在「确实没缓存」的请求上,避免锁内重复回源:
text
第一检:先查缓存
  ├─► 命中 → 直接返回
  └─► 未命中 → 尝试加锁
                 ├─► 抢不到锁 → 等待 / 重试
                 └─► 抢到锁 → 第二检:再查一次缓存
                                 ├─► 已有(别人刚回填)→ 返回,不再查 DB
└─► 仍无 → 查 DB → 回填缓存 → 释放锁上面的 get_hot_goods 伪代码本质就是「第一检 + 抢锁」,再补一次锁内「第二检」即可,典型写法如下:
python
def get_hot_goods(goods_id: str):
    cache_key = f"goods:{goods_id}"
    lock_key = f"lock:goods:{goods_id}"

    # 第一检:先查缓存,命中直接返回
    cached = redis_client.get(cache_key)
    if cached is not None:
        return cached

    # 加锁后做第二检,避免锁内重复回源
    if redis_client.set(lock_key, "1", nx=True, ex=10):
        try:
            cached = redis_client.get(cache_key)  # 第二检
            if cached is not None:
                return cached

            goods = db.query_goods(goods_id)
            redis_client.set(cache_key, goods, ex=600)
            return goods
        finally:
            redis_client.delete(lock_key)

    time.sleep(0.05)
return get_hot_goods(goods_id)方案 2:逻辑过期(缓存「永不过期」)
缓存 key 本身不设过期时间(或设一个很长的兜底时间),把真实过期时间放进 value 里。读取时发现「逻辑已过期」,先返回旧值,再异步去刷新:
text
value 结构:{ "data": {...}, "expire_at": 1787800000 }

读请求:
  └─► 读缓存 → 命中 → 判断 expire_at 是否已过
        ├─► 未过期 → 直接返回 data
└─► 已过期 → 先返回旧 data,同时异步触发回源刷新这种方案几乎不会出现「并发回源」,因为它始终先返回旧值,刷新由后台线程或单独的任务完成。代价是数据在刷新完成前会短暂不一致,适合「能容忍短时间旧数据」的热点场景。
方案 3:热点预热
对已知热点(大促商品、首页数据),在过期前主动刷新,或者干脆不设过期。属于提前规避,而非事后补救。
方案 4:二级缓存(主 A 副 B)
用两个缓存(主缓存 A、副缓存 B)互为备份,靠「副缓存过期更久」来兜住主缓存失效的空窗:
- 查询:先读主缓存 A,A 没命中再读副缓存 B;
- 更新:先删 B → 更新 B → 再删 A → 再更新 A;
- 过期时间:B 的过期时间大于 A,保证 A 失效时 B 还能顶上去继续挡请求。
text
请求 ──► 主缓存 A(TTL 短,如 10 分钟)
              └─► 命中 → 返回
              └─► 未命中 → 副缓存 B(TTL 长,如 30 分钟)
                              └─► 命中 → 返回(同时可异步回填 A)
└─► 未命中 → 回源 DB它的本质是「打一组错峰过期的缓存」,让 A、B 不会同时失效,从而避免热点数据空窗期内并发打穿。代价是维护两份缓存、占用额外内存,且更新时要处理好 A/B 的一致性顺序。
二、缓存雪崩的解决(针对大面积失效)
核心矛盾是「大量 key 同时失效」或「Redis 整体不可用」。解决思路是打散、兜底、保命。
方案 1:过期时间随机化
这是最常用、成本最低的手段。给每个 key 的 TTL 加一个随机偏移,避免集中在同一秒过期:
python
import random

base_ttl = 600
redis_client.set(f"goods:{goods_id}", goods, ex=base_ttl + random.randint(0, 180))让过期时间从「都在 600 秒」变成「600~780 秒随机分布」,把瞬间的洪峰摊平成持续的小流量。
方案 2:Redis 高可用
如果雪崩的源头是 Redis 宕机,那就要从架构上保证缓存层不整体挂掉:
- 主从复制 + 哨兵(Sentinel):主节点挂掉后自动选举新主,保证可用性;
- Redis Cluster:分片 + 自动故障转移,单分片故障不影响整体;
- 避免单点,部署多个实例。
方案 3:多级缓存 / 本地缓存兜底
在应用进程内加一层本地缓存(如 Caffeine、Guava、Python 的 functools.lru_cache 或本地字典)。当 Redis 不可用时,先用本地缓存顶住,避免直接压到数据库:
text
请求 → 本地缓存(进程内)→ Redis(分布式缓存)→ 数据库
命中即返回 命中即返回 最后兜底本地缓存虽然各实例之间不一致,但作为「降级兜底」足够挡住致命洪峰。
方案 4:限流、降级、熔断
当检测到数据库压力过大时,主动限流(拒绝部分请求)、降级(返回兜底数据或默认页)、熔断(短时间内直接快速失败)。这是保护数据库的「最后一道闸门」。
三、击穿与雪崩解决手段汇总
| 问题 | 解决手段 | 核心思路 | 成本 / 权衡 |
|---|---|---|---|
| 缓存击穿 | 互斥锁 / 分布式锁(双检加锁) | 串行化回源,只让一个请求查 DB | 引入锁复杂度,需要锁超时防死锁 |
| 缓存击穿 | 逻辑过期(永不过期 + 异步刷新) | 始终先返回旧值,后台异步刷新 | 短暂数据不一致,需要额外刷新机制 |
| 缓存击穿 | 热点预热 | 过期前主动刷新 | 需提前识别热点 |
| 缓存击穿 | 二级缓存(主 A 副 B) | 错峰过期,副缓存兜住空窗 | 两份缓存占内存,需维护 A/B 一致性 |
| 缓存雪崩 | 过期时间随机化 | 打散过期时间,摊平洪峰 | 实现简单,但不是万能的 |
| 缓存雪崩 | Redis 高可用(哨兵/集群) | 保证缓存层不整体宕机 | 架构成本,需运维投入 |
| 缓存雪崩 | 多级缓存 / 本地缓存 | 本地兜底,挡住致命洪峰 | 本地缓存各实例不一致 |
| 缓存雪崩 | 限流 / 降级 / 熔断 | 保护数据库最后一道闸门 | 可能牺牲部分用户体验 |
小结
| 问题 | 一句话本质 | 首选方案 | 次选 / 增强 |
|---|---|---|---|
| 缓存穿透 | 查不存在的数据,缓存永远挡不住 | 参数校验 + 缓存空值(回写增强) | 布隆过滤器 / 黑白名单 + 限流熔断 |
| 缓存击穿 | 热点 key 过期瞬间被并发打穿 | 互斥锁 / 分布式锁(双检加锁,强一致)或逻辑过期(高可用) | 热点预热 / 二级缓存 |
| 缓存雪崩 | 大量 key 同时失效引发洪峰 | 过期时间随机化 + Redis 高可用 | 多级缓存 + 限流降级熔断 |